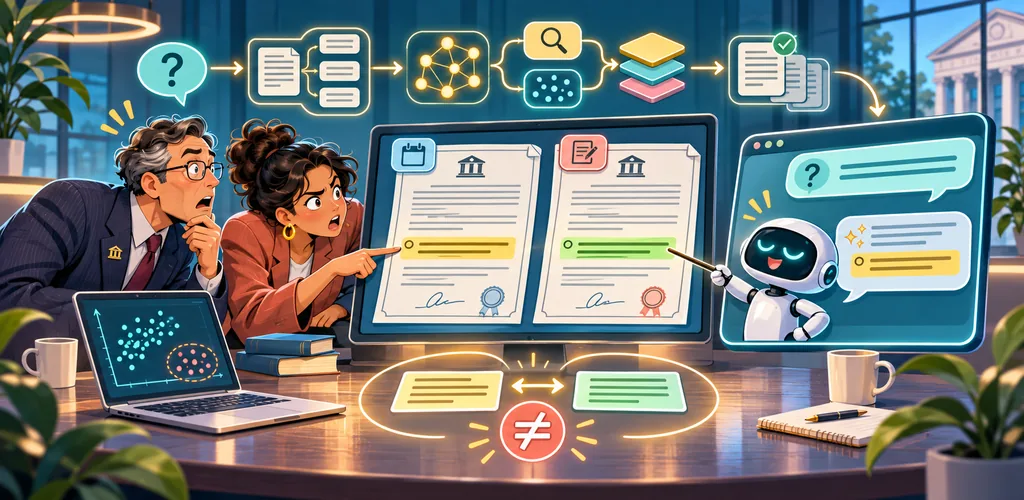
RAG ist keine Vektordatenbank mit Chatfenster.
- Stefan Poss
- Tech lens
- 5. November 2026
Table of Contents
Warum eine überzeugende AI-Antwort noch keine verlässliche Suche beweist.
Die Demo läuft. Ein paar Kreditverträge hochgeladen, Texte in Chunks geschnitten, Embeddings berechnet, Vektoren gespeichert. Ein Chatfenster darüber. Fertig ist RAG.
Dann kommt die erste richtige Frage aus dem Kreditgeschäft:
„Welche Zinsanpassung gilt für Vertrag K-123 nach dem letzten Nachtrag?“
Das System antwortet selbstbewusst: 1,5 Prozent. Der Satz klingt plausibel. Sogar eine Quelle ist dabei.
Nur stammt die Quelle aus der ursprünglichen Vertragsfassung. Im späteren Nachtrag steht etwas anderes.
Technisch hat die Vektorsuche einen ähnlichen Text gefunden. Fachlich hat sie die entscheidende Frage nicht beantwortet.
Die Bank, der Vertrag und die Werte sind fiktiv. Der Fall illustriert ein typisches Retrieval-Risiko.
Das Problem beginnt vor dem LLM
Retrieval-Augmented Generation, kurz RAG, bedeutet: Wir suchen Informationen und geben sie einem Sprachmodell als Kontext. Das Modell formuliert dann eine Antwort – idealerweise mit überprüfbaren Quellen.
Dokument → Extraktion → Chunks → Embeddings → Suchindex

Frage → Retrieval → Quellpassagen → LLM → Antwort
Das ist eine nützliche Grundskizze. Aber in ihr fehlt fast alles, was unsere Vertragsfrage schwierig macht: Identifikatoren, Versionen, Beziehungen, Berechtigungen und Auswahlregeln.
Genau hier liegt für mich die entscheidende Architekturfrage: Wie bringen wir das System dazu, nicht nur ähnliche Texte zu finden, sondern die richtigen Informationen im richtigen Kontext?
Was ein Embedding kann – und was nicht
Ein Embedding-Modell verwandelt Text in einen Vektor. Ähnlich formulierte Abschnitte können im Vektorraum nah beieinanderliegen. Das hilft beispielsweise, wenn jemand „Darlehen“ fragt und im Dokument „Kreditvereinbarung“ steht.
Aber ein Vektor ist weder eine Datenbankrelation noch ein Beweis für fachliche Gültigkeit.
Die Sätze „Der Zinssatz beträgt 1,5 %“ und „Der Zinssatz beträgt 15 %“ können ähnlich eingebettet werden. Vertragsnummern sind ebenfalls schlechte Kandidaten für eine rein semantische Interpretation.
Darum würde ich drei Dinge voneinander trennen:
- Exakte Identität: Welcher Vertrag und welche Kundenzuordnung sind gemeint?
- Gültiger Kontext: Welche Fassung, welcher Nachtrag und welcher Zeitraum gelten?
- Semantische Relevanz: Welche Passagen beantworten die inhaltliche Frage?
Eine einzelne Cosine-Similarity-Sortierung modelliert diese drei Fragen nicht zuverlässig.
Ein guter Chunk braucht mehr als Text
Beim Chunking zerlegen wir lange Dokumente in kleinere Einheiten. Hier sehe ich oft die erste unterschätzte Entscheidung.
Fixed-Size Chunking ist einfach, kann aber eine Zinstabelle von ihrer Überschrift trennen. Structure-Aware Chunking nutzt Absätze, Überschriften, Tabellen und Dokumentabschnitte. Hierarchical Chunking sucht auf kleinen Abschnitten und liefert anschließend einen größeren Elternkontext. Semantic Chunking versucht zusätzlich, Themenwechsel zu erkennen.
Für einen Vertrag mit Nachträgen würde ich strukturorientiertes oder hierarchisches Chunking zunächst gegen eine einfache Fixed-Size-Baseline testen. „Besser“ ist eine Hypothese, die Retrieval-Metriken bestätigen müssen.
Jeder Chunk braucht außerdem Herkunft:
{
  "chunk_id": "CH-789",
  "document_id": "DOC-K123-NACHTRAG-2",
  "contract_id": "K-123",
  "document_type": "loan_amendment",
  "extraction_id": "EXT-002",
  "valid_from": "2026-01-01",
  "section": "Zinsanpassung",
  "page": 4,
  "content": "Ab dem Stichtag gilt ..."
}
Ohne diese Metadaten kann die Suche möglicherweise einen sehr relevanten Satz finden – nur eben nicht den gültigen. Ob ein Nachtrag eine Klausel tatsächlich ersetzt, ist im Übrigen eine fachliche Beziehung, die geprüft werden muss. Das folgt nicht automatisch aus dem jüngsten Datum.
Unsere Vertragsfrage als Retrieval-Durchlauf
Ich würde die Suche nach „K-123 nach dem letzten Nachtrag“ in mehrere kontrollierte Schritte zerlegen.
Schritt 1: Query verstehen. Die Frage enthält einen exakten Identifikator (K-123), eine inhaltliche Absicht (Zinsanpassung) und einen Versionsbezug (letzter Nachtrag). Dafür brauchen wir kein freies SQL aus einem LLM, sondern einen begrenzten, validierten Query-Plan.
{
  "intent": "find_contract_terms",
  "contract_id": "K-123",
  "concept": "interest_adjustment",
  "version_scope": "latest_applicable"
}
Schritt 2: Autorisierung und Identität. Zuerst prüfen wir, welche Dokumente der anfragende Nutzer sehen darf. Dann ermitteln wir die Dokumentfamilie des Vertrags. Hier helfen Metadaten, relationale Indizes oder ein Semantic Layer mit stabilen fachlichen Konzepten.
Schritt 3: Kandidaten eingrenzen. Wir berücksichtigen den Ursprungskreditvertrag sowie zugehörige Nachträge und ermitteln, welche Fassung für den angefragten Zeitpunkt maßgeblich ist. Diese Gültigkeit muss aus dokumentierten Beziehungen und Regeln folgen, nicht aus einer vagen semantischen Ähnlichkeit.
Schritt 4: Hybrid Retrieval. Innerhalb der zugelassenen Kandidaten kombinieren wir Keyword Search für Zinsbegriffe und Kennungen mit Vector Search für Paraphrasen. Ein Fusionsverfahren wie Reciprocal Rank Fusion kann Trefferranglisten zusammenführen; ein Reranker kann danach die verbleibenden Passagen bewerten.
Schritt 5: Kontext und Antwort. Wir laden bei Bedarf den zugehörigen Paragraphen oder die ganze Tabellenzeile nach und übergeben dem Modell die maßgeblichen Stellen inklusive Quellen. Wenn die Vertragsgeltung unklar ist, muss das System Unsicherheit melden statt eine eindeutige Zinsanpassung zu erfinden.
Frage: "K-123, Zinsanpassung nach Nachtrag?"
   ↓
Authentifizierung + Berechtigungen
   ↓
Vertrag K-123 und erlaubte Dokumentfamilie
   ↓
Gültige Fassung / Nachtragsbeziehungen
   ↓
Keyword Search + Vector Search
   ↓
Fusion / optionaler Reranker
   ↓
Abschnitt + Quellen + Gültigkeitsprüfung
   ↓
Antwort oder begründete Unsicherheit
Das ist ein viel stärkerer Retrieval-Contract als „Top 10 ähnlichste Chunks“.
Wo gehören die Daten hin?
Für interaktive, relationale Abfragen ist PostgreSQL mit pgvector eine plausible Option: Vertragsmetadaten, Joins, PostgreSQL Full Text Search und Vektorsuche können innerhalb eines Systems kombiniert werden. HNSW ist ein Indexansatz für approximative Similarity Search.
BigQuery Vector Search bietet sich an, wenn die Plattform stark von BigQuery-Daten, analytischen Workloads oder Batch-Verarbeitung geprägt ist. Auch hier braucht es geeignete Filter- und Datenmodelle.
Und MongoDB Atlas Vector Search kann sinnvoll sein, wenn Dokumentmetadaten bereits dort liegen und die technischen und betrieblichen Voraussetzungen passen.
Die Entscheidung hängt von Datenvolumen, Änderungsrate, Latenzanforderung, Indexverhalten und Kosten ab. Vor allem bei gefilterter ANN-Suche muss man messen, wie gut Filter und Vektorindex zusammenarbeiten. Ein WHERE in einer Beispielquery garantiert noch keinen effizienten Ausführungsplan.
Die wichtigste Architekturregel ist für mich deshalb nicht „nutze immer Datenbank X“, sondern: Halte den Retrieval-Contract unabhängig von der konkreten Speichertechnologie.
Eine Dokumentbasis. Unterschiedliche Suchprodukte.
Das Basisextrakt aus der Dokumentenplattform bleibt unveränderlich. Ein RAG-Profil definiert dagegen, wie Chunks erzeugt, eingebettet, indiziert und gesucht werden:
rag_profile:
  id: lending-contract-search
  version: "2.1"
  extraction_quality_minimum: L2
  chunking: structure_aware
  retrieval:
    mode: hybrid
    top_k: 10
    rerank: true
  metadata_filters:
    - contract_id
    - document_type
    - valid_from
Das ist wieder ein Architekturbeispiel, keine fertige ausführbare Konfiguration. Ein anderer Consumer darf eine andere Strategie wählen, ohne deshalb alle PDFs erneut zu extrahieren.
Ein Embedding-Modellwechsel führt in der Regel zu neuen Vektoren. Eine Änderung der Chunking-Strategie ebenfalls. Eine reine Änderung der fachlichen Filterzuordnung muss hingegen nicht alle Embeddings neu berechnen.
Die wichtigste Frage lautet nicht: Wie schnell war die Demo?
Wir brauchen einen repräsentativen Eval-Satz mit Fragen, für die die korrekten Quellen bekannt sind. Dann messen wir Recall@k, nDCG@k, korrekte Versionsauflösung, Zitiergenauigkeit, Berechtigungsisolation, Kosten und Latenz.
Für unsere Vertragsfrage ist eine besonders hilfreiche Prüfung: Findet das System die gültige Nachtragsklausel – und verwirft es die ähnliche, aber veraltete Klausel?
Eine erfolgreiche Chat-Antwort im Demo-Call ist dafür kein Nachweis.
Mein Fazit
Embeddings sind wichtig. Chunking ist wichtig. Eine gute Datenbank ist wichtig.
Aber ein RAG-System wird nicht dadurch zuverlässig, dass wir die ähnlichsten Wörter besonders schnell finden.
Wir müssen Identität, Gültigkeit, Berechtigung und Bedeutung gemeinsam behandeln. Erst dann kann die Vektorsuche ihren eigentlichen Nutzen entfalten.
Welche reale Nutzerfrage würde eure RAG-Demo heute am ehesten zum Stolpern bringen?
Im nächsten Beitrag wird es unbequem: Was passiert, wenn sich die fachlichen Definitionen hinter diesen Suchfiltern ändern?