Wenn KI den Code schreibt, wer entwickelt dann eigentlich die Software?
- Stefan Poss
- Tech lens
- 1. November 2026
Table of Contents
Wenn KI den Code schreibt, wer entwickelt dann eigentlich die Software?
Warum KI-Agenten nicht nur die Programmierung beschleunigen, sondern unsere Zusammenarbeit verändern.
Stell dir vor, du beauftragst ein Entwicklungsteam mit einer neuen Funktion für ein Kundenportal. Kunden sollen Dokumente hochladen und anschließend verfolgen können, ob diese eingegangen sind, bearbeitet werden oder bereits abgeschlossen wurden.
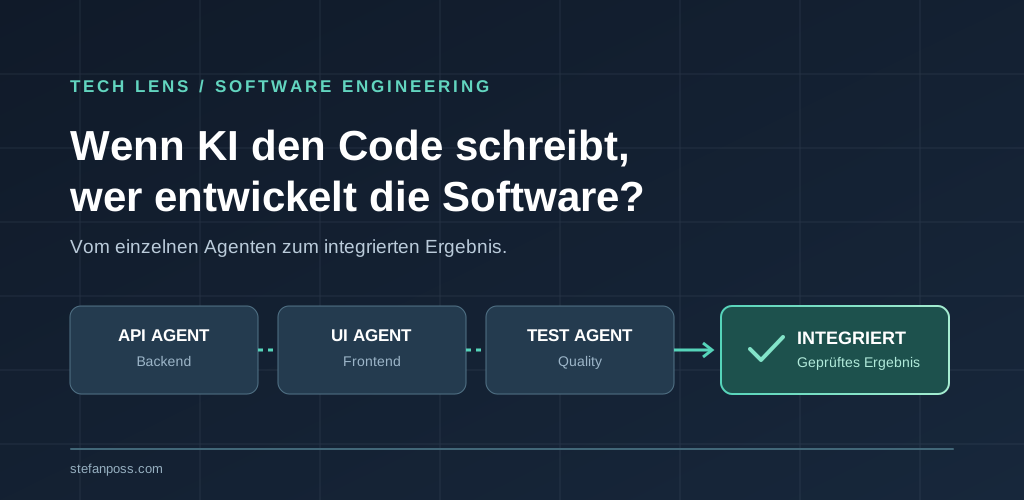
Ein Entwickler startet einen Coding-Agenten für die API. Ein zweiter Agent baut die Benutzeroberfläche. Ein dritter kümmert sich um die Tests.
Wenig später melden alle drei Erfolg.
„Implementation completed.“ „Feature ready.“ „All tests passed.“
Fantastisch. Drei Agenten, drei Erfolgsmeldungen. Das Team könnte eigentlich direkt zum Feierabend übergehen.
Es gibt nur ein kleines Problem: Die API liefert den Status success. Die Oberfläche erwartet completed. Und die Tests prüfen auf done.
Drei erfolgreiche Aufgaben. Eine nicht funktionierende Anwendung.
Willkommen in einer neuen Disziplin der Softwareentwicklung: Wir müssen nicht mehr nur Menschen koordinieren, sondern auch Maschinen, die unglaublich schnell aneinander vorbeientwickeln können.
Die Szene ist fiktiv. Das Integrationsproblem ist realistisch.
Der Code ist nicht mehr zwingend der Engpass
Wir haben unsere Entwicklungsarbeit lange um Menschen organisiert, die Anforderungen verstehen, Lösungen entwerfen, Code schreiben, testen und Änderungen ausliefern.
Coding-Assistenten vereinfachten zunächst einzelne Schritte. KI-Agenten können inzwischen größere, abgegrenzte Aufträge untersuchen, Dateien verändern, Tests ausführen und Ergebnisse zur Prüfung vorlegen.
Dadurch wird Codeproduktion potenziell schneller. Softwarelieferung aber nicht automatisch.
Wenn ein Agent in wenigen Minuten implementiert, die fachliche Klärung zwei Tage dauert und die Integration weitere drei, haben wir vor allem den sichtbarsten Teil beschleunigt. Nicht unbedingt den wichtigsten.
Der Engpass kann sich vom Schreiben des Codes zur Koordination, Integration und Bewertung der Ergebnisse verschieben. Das hängt vom Projekt ab, ist aber ein guter Grund, unseren Engineering-Prozess nicht unverändert zu lassen.
Der Entwickler wird zum Orchestrator – nicht zum Zuschauer
Engineering-Orchestrator klingt verdächtig nach einer neuen Rolle, für die bald jemand eine Zertifizierung verkauft.
Dabei steckt etwas Einfaches dahinter: Jemand muss dafür sorgen, dass alle Beteiligten dasselbe Ziel verfolgen, ihre Aufgaben zueinander passen und aus den Einzelteilen eine brauchbare Lösung wird.
Bei Menschen tun wir das längst. Wir schneiden Aufgaben, klären Abhängigkeiten, vereinbaren Schnittstellen und überprüfen Ergebnisse.
Bei KI-Agenten wird diese Fähigkeit noch wichtiger, weil sie Ergebnisse oft schneller erzeugen, als wir sie sinnvoll prüfen können.
Die Fragen verändern sich: Welche Aufgaben sind tatsächlich unabhängig? Welche Entscheidungen müssen zuerst fallen? Welchen Kontext braucht ein Spezialist? Wo sind automatische Nachweise ausreichend, wo braucht es menschliche Verantwortung?
Das bedeutet nicht, dass Entwickler künftig keinen Code mehr verstehen müssen. Im Gegenteil: Wer eine API fachlich nicht versteht, kann ihre falsche Implementierung auch mit zwanzig Agenten kaum zuverlässig beurteilen.
Weniger Aufmerksamkeit für jede einzelne Codezeile. Mehr Verantwortung für das Verhalten des Gesamtsystems.
Ein Feature, mehrere Agenten – aber zuerst eine gemeinsame Vereinbarung
Zurück zu unserem Dokumentenupload.
Die Versuchung ist groß, sofort vier Agenten zu starten: Backend, Frontend, Infrastruktur, Tests. Nur haben wir dann noch nicht entschieden, was die Komponenten einander versprechen.
1. Das Ziel klären
Der Product Owner definiert ein beobachtbares Ergebnis:
Ein angemeldeter Kunde kann ein unterstütztes Dokument hochladen. Das System bestätigt den Eingang mit einer eindeutigen Dokument-ID. Der Kunde kann den Bearbeitungsstatus abrufen. Andere Kunden dürfen weder das Dokument noch seinen Status einsehen. Fehler werden verständlich angezeigt.
Ein Product-Agent kann offene Fragen aufdecken: Welche Dateitypen sind erlaubt? Was geschieht bei doppelten Uploads? Was bedeutet „verarbeitet“? Die zuständige Person entscheidet, welche Antworten gelten.
Wenn wir diese Fragen auslassen, treffen die Agenten eigene Annahmen. Und Annahmen lassen sich heute erschreckend schnell implementieren.
2. Die Schnittstellen vereinbaren
Ein Engineering Lead untersucht das bestehende System und vereinbart mit dem Team die erforderlichen Verträge.
Ein erfolgreicher Eingang könnte so aussehen:
POST /documents
→ 202 Accepted

{
  "document_id": "doc-123",
  "status": "received"
}
Der Status wird später unter derselben ID abgefragt:
GET /documents/doc-123
→ 200 OK

{
  "document_id": "doc-123",
  "status": "processing"
}
Für dieses Beispiel gelten gemeinsam festgelegte Werte: received, processing, completed und failed. Dazu kommen verbindliche Berechtigungs- und Fehlerregeln.
Wir schreiben damit nicht jede Implementierungsentscheidung vor. Wir legen fest, wo unabhängige Arbeit wieder zusammenpassen muss.
Jetzt wissen Frontend, Backend und Tests, welche Zusagen sie erfüllen sollen. Die Agenten sind nicht langsamer geworden. Aber sie entwickeln endlich dieselbe Funktion.
3. Nur unabhängige Arbeit parallelisieren
Erst jetzt verteilen wir Aufgaben.
Der Backend-Agent implementiert Upload und Statusabfrage. Der Frontend-Agent entwickelt die Oberfläche gegen den vereinbarten Vertrag. Ein Infrastruktur-Spezialist bereitet die notwendigen Ressourcen vor. Ein Test-Spezialist formuliert Prüfungen aus den Akzeptanzkriterien.
Dabei gelten klare Grenzen: Abhängigkeiten werden vor der Verteilung geklärt. Schreibbereiche sollen sich möglichst nicht überschneiden. Eine benannte Person oder ein Integrator verantwortet das Zusammenführen.
Zwei Agenten, die gleichzeitig dieselbe Datenbankstruktur ändern und unterschiedliche Migrationen erzeugen, liefern keinen doppelten Fortschritt. Sie liefern zwei konkurrierende Wahrheiten über unsere Datenbank.
Parallelisierung ist das Ergebnis guter Aufgabenzerlegung, nicht ihr Ersatz.
Für eine kleine Korrektur reicht übrigens oft ein einzelner Agent. Ein Tippfehler braucht kein Architekturkomitee aus sechs Sprachmodellen.
Nach „Task completed“ beginnt die eigentliche Prüfung
Backend fertig. Frontend fertig. Infrastruktur vorbereitet. Tests grün.
Sind wir fertig?
Noch nicht. Denn lokale Erfolge belegen kein integriertes Verhalten.
Eine API kann auf ihrem Branch funktionieren, während die Oberfläche Fehler falsch behandelt. Ein Test kann grün sein, weil er dieselbe falsche Annahme prüft wie der Implementierungs-Agent. Und ein vermeintlich fertiger Upload kann fremde Dokumente zugänglich machen.
Deshalb braucht unser Ablauf einen bewussten Integrationspunkt. Änderungen werden zusammengeführt und auf der gemeinsamen Revision geprüft.
Für unser Kundenportal heißt das: Ein Kunde lädt ein Dokument hoch, erhält eine ID und sieht später den richtigen Status. Ein fremder Kunde wird beim Abruf abgewiesen. Fehler werden verständlich angezeigt. Doppelte Eingaben und vorübergehende Ausfälle werden kontrolliert behandelt.
Jetzt zählt nicht mehr, ob jeder Agent seine Aufgabe als erfolgreich markiert hat. Jetzt zählt, ob das Gesamtsystem die fachliche Zusage erfüllt.
Ein Agent kann eine Aufgabe abgeschlossen haben, ohne dass das Team schon eine akzeptierbare Änderung geliefert hat.
Quality Gates müssen mit der Geschwindigkeit mitwachsen
Je schneller wir Änderungen erzeugen, desto wichtiger wird eine verlässliche Prüfung.
Ein zweiter KI-Agent kann einen wertvollen unabhängigen Blick liefern. Er kann aber auch dieselben Fehlannahmen wie der erste teilen. Drei Modelle, die sich gegenseitig zustimmen, sind noch kein Qualitätsnachweis.
Entscheidend ist, wogegen geprüft wird.
Unsere Erwartungen sollten aus Anforderungen, gemeinsam vereinbarten Verträgen und konkreten Risiken stammen – nicht bloß aus dem bereits geschriebenen Code.
Beim Dokumentenupload wären das beispielsweise:
- Ein berechtigter Kunde kann hochladen und seinen Status abrufen.
- Ein anderer Kunde erhält keinen Zugriff auf Dokument und Status.
- Die Komponenten verwenden dieselben Status- und Fehlerverträge.
- Wichtige Wiederholungs- und Ausfallfälle sind geprüft.
- Der Nachweis bezieht sich auf die tatsächlich integrierte Revision.
- Für risikoreiche Änderungen gibt es einen kontrollierten Rollout- und Rückweg.
Nicht jede Änderung braucht dieselben Prüfungen. Eine Textkorrektur ist keine Berechtigungsmigration.
Und ein grüner Build beweist, dass die vorgesehenen Checks bestanden wurden. Nicht, dass der Kunde sein Ziel erreicht.
Wie ein AI-native Engineering Lifecycle aussehen kann
Für mich ergibt sich daraus ein einfacher Rahmen aus sechs Aktivitäten, die je nach Aufgabe unterschiedlich viel Gewicht haben.
Frame: Wir klären den Nutzerbedarf, Grenzen und beobachtbare Akzeptanzkriterien. Die fachliche Verantwortung bleibt bei Menschen.
Shape: Wir prüfen das bestehende System, wählen eine tragfähige Lösung, vereinbaren Schnittstellen und erkennen Abhängigkeiten.
Build: Wir delegieren abgegrenzte Aufgaben an Menschen und KI-Agenten. Unabhängige Arbeit kann parallel stattfinden.
Verify: Wir prüfen gegen Anforderungen, Verträge und Risiken. Wichtige Nachweise beziehen sich auf die konkrete Änderung.
Integrate & Release: Ein Integrator führt die Ergebnisse zusammen. Die Gesamtfunktion wird geprüft; zuständige Menschen entscheiden über Abnahme und Veröffentlichung.
Learn: Wir analysieren Reibungsverluste, Nacharbeit und Fehler. Relevante Erkenntnisse und Entscheidungen bleiben für das nächste Team oder den nächsten Agenten verfügbar.
Das ist keine starre Sechs-Phasen-Bürokratie. Eine kleine Korrektur kann in einer Sitzung von der Anfrage zur Prüfung gehen. Bei einer größeren Funktion wechseln wir möglicherweise mehrfach zwischen Entwurf, Umsetzung und Verifikation.
AI-native bedeutet nicht, möglichst viele Prozessschritte zu automatisieren. Es bedeutet, menschliche und maschinelle Arbeit so zu verbinden, dass verlässliche Ergebnisse entstehen.
Ein erster Versuch für dein eigenes Team
Man muss nicht das ganze Unternehmen umbauen, um diesen Ansatz auszuprobieren.
Nimm eine überschaubare Funktion mit mindestens zwei Komponenten – etwa einen API-Endpunkt und eine kleine Oberfläche.
Halte vor der Implementierung vier Dinge fest:
- Ziel: Welches Verhalten muss für den Nutzer funktionieren?
- Vertrag: Welche Schnittstellen, Statuswerte und Berechtigungen teilen die Komponenten?
- Arbeitsteilung: Welche Aufgaben können wirklich unabhängig entstehen?
- Abnahme: Welche Prüfungen belegen das integrierte Ergebnis?
Dann lasse zwei geeignete Agenten die abgegrenzten Aufgaben bearbeiten. Führe die Ergebnisse zusammen. Miss, wie viel Zeit und Nacharbeit bis zur tatsächlich akzeptierten Änderung entstanden ist.
Das ist aussagekräftiger als ein Screenshot von fünf gleichzeitig laufenden Agenten.
Vom gemeinsamen Prozess zum AI-native Engineering
Dieser Gedanke führt zwei meiner bisherigen Beiträge weiter.
In „Scrum, Chaos und Klarheit“ ging es darum, warum agile Methoden ohne klare Ziele und Verantwortung zum Selbstzweck werden.
In „Wie wir arbeiten, weiß Lisa. Lisa hat Urlaub.“ habe ich beschrieben, weshalb gemeinsame Engineering-Standards, nachvollziehbare Entscheidungen und zugängliches Projektwissen wichtig sind.
Beide schaffen die Grundlage: Wir müssen wissen, was wir erreichen wollen, und gemeinsam verstehen, wie wir arbeiten.
Mit KI-Agenten kommt eine dritte Frage hinzu: Wie organisieren wir die eigentliche Entwicklungsarbeit, wenn Maschinen selbstständig abgegrenzte Aufgaben übernehmen können?
Genau darum geht es hier. Nicht darum, bestehende Prozesse noch einmal zu dokumentieren, sondern darum, wie sich Aufgabenverteilung, Verantwortung und Qualitätsprüfung innerhalb dieser Prozesse verändern.
Wie ich das praktisch angehe
Mit meinem Open-Source-Projekt ai-agents beschäftige ich mich mit diesen Fragen.
Das Projekt beschreibt ein Engineering Operating Model, in dem Menschen Ziele und wesentliche Entscheidungen verantworten, während KI-Agenten abgegrenzte Aufgaben übernehmen können. Dazu gehören Produkt-, Architektur- und Delivery-Perspektiven, klar beschriebene Aufträge, Orchestrierung und unabhängige Prüfungen.
Der Ansatz ist kein Beweis für höhere Produktivität. Ob er hilft, hängt von der Aufgabe, den Modellen, den Schnittstellen und der Qualität der Überprüfung ab.
Genau deshalb sollten wir nicht nur betrachten, wie viel Arbeit Agenten erledigen, sondern was davon als funktionierende Software ankommt.
Was wir wirklich messen sollten
Tokenverbrauch, Modellpreise und Anzahl der Agenten sind nützliche Betriebsgrößen. Allein sagen sie wenig über den Nutzen.
Spannender sind die Fragen: Wie lange dauert es von einer geklärten Anforderung bis zur akzeptierten Änderung? Wie viel menschliche Review-Zeit wird benötigt? Wie viel Nacharbeit entsteht? Welche Fehler tauchen erst nach der Integration auf? Und welchen Nutzen hat die Funktion für ihre Anwender?
Die tatsächlichen Modell- und Infrastrukturkosten gehören selbstverständlich dazu.
Wenn fünf Agenten doppelt so schnell implementieren, wir anschließend aber dreimal so viel Integrationsarbeit haben, ist das keine überzeugende Erfolgsgeschichte.
Produktivität zeigt sich nicht daran, wie viel Code entsteht, sondern wie zuverlässig wir nutzbare Veränderungen liefern.
Fazit: Die Zukunft gehört nicht dem schnellsten Coding-Agenten
Unser fiktives Team hätte den Dokumentenupload vielleicht sogar mit einem einzelnen Agenten erfolgreicher umgesetzt als mit drei unkoordinierten Spezialisten.
Der Unterschied liegt nicht in der Anzahl der Agenten. Er liegt darin, ob Ziele, Schnittstellen, Verantwortung und Integration stimmen.
KI eröffnet uns neue Möglichkeiten, Entwicklungsarbeit aufzuteilen und zu beschleunigen. Sie nimmt uns nicht die Verantwortung ab, dass am Ende eine funktionierende und sichere Lösung entsteht.
Vielleicht sollten wir nach der nächsten Entwicklungssession deshalb weniger fragen: „Wie viele Tasks haben die Agenten erledigt?“
Sondern:
„Wie viel davon funktioniert eigentlich schon zusammen?“
Und jetzt interessiert mich: Was ist bei euch der größte Engpass – das Schreiben des Codes, die Abstimmung oder die Integration der Ergebnisse?